xAI ·
SpaceXAI wypuszcza Grok 4.7
SpaceXAI wypuścił Grok 4.7. To najmocniejszy model firmy do kodowania i pracy na wiedzy. Ma dłużej siedzieć przy trudnych zadaniach, ogarniać więcej kontekstu i ostrożniej sprawdzać własne odpowiedzi.
Główne zmiany:
- nowy, większy model bazowy
- dłuższy trening na wielogodzinnych zadaniach
- lepiej weryfikuje własne odpowiedzi
- lepszy długi kontekst
- lepsze dokumenty i prezentacje
- natywnie rozumie system Grok Bota
- mocniejsze zabezpieczenia i ochrona przed jailbreakiem
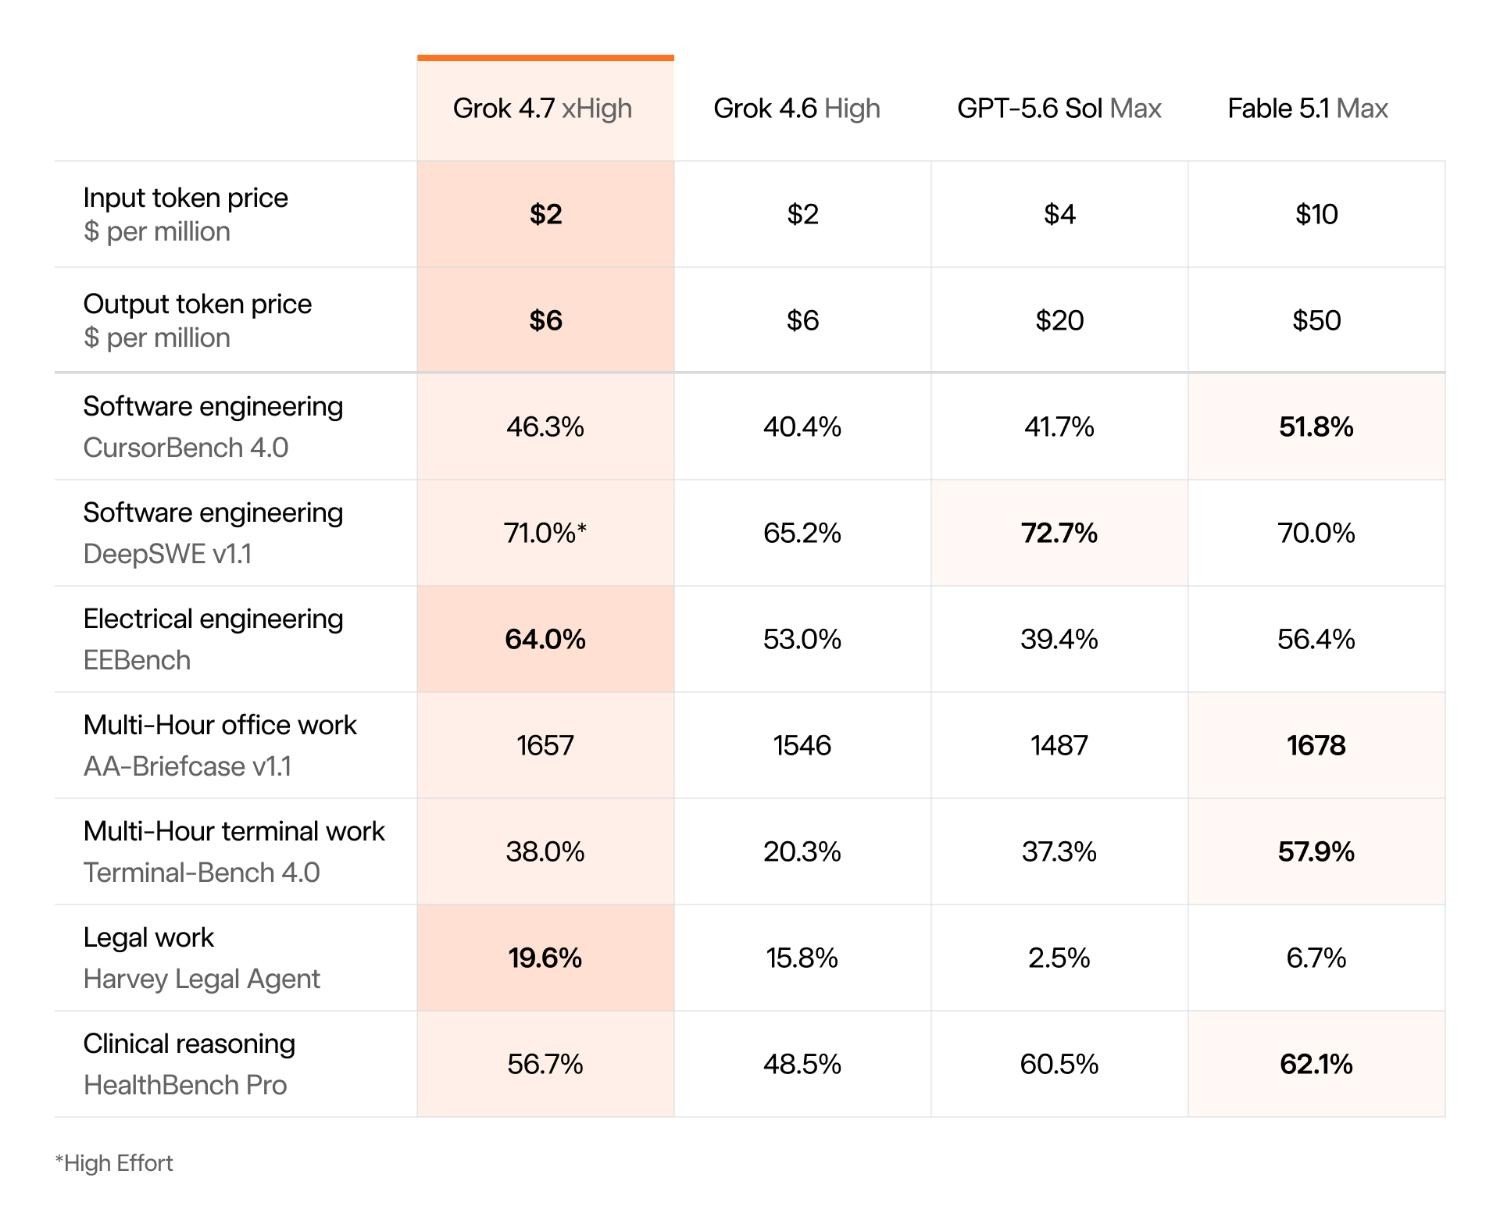
Wyniki Grok 4.7 xhigh wobec 4.6 high:
- CursorBench 4.0: 46,3%, z 40,4%
- DeepSWE v1.1: 71,0% przy wysokim wysiłku, z 65,2%
- AA Briefcase v1.1: 1657, z 1546
- Terminal-Bench 4.0: 38,0%, z 20,3%
- Harvey Legal: 19,6%, z 15,8%
- HealthBench Professional: 56,7%, z 48,5%
- EEBench: 64,0%, z 53,0%
Na Harvey Legal i EEBench Grok 4.7 wyprzedza GPT-5.6 Sol Max i Fable 5.1 Max. Na CursorBench 4.0 Fable 5.1 Max zostaje wyżej, 51,8%. DeepSWE wygrywa Sol, 72,7%.
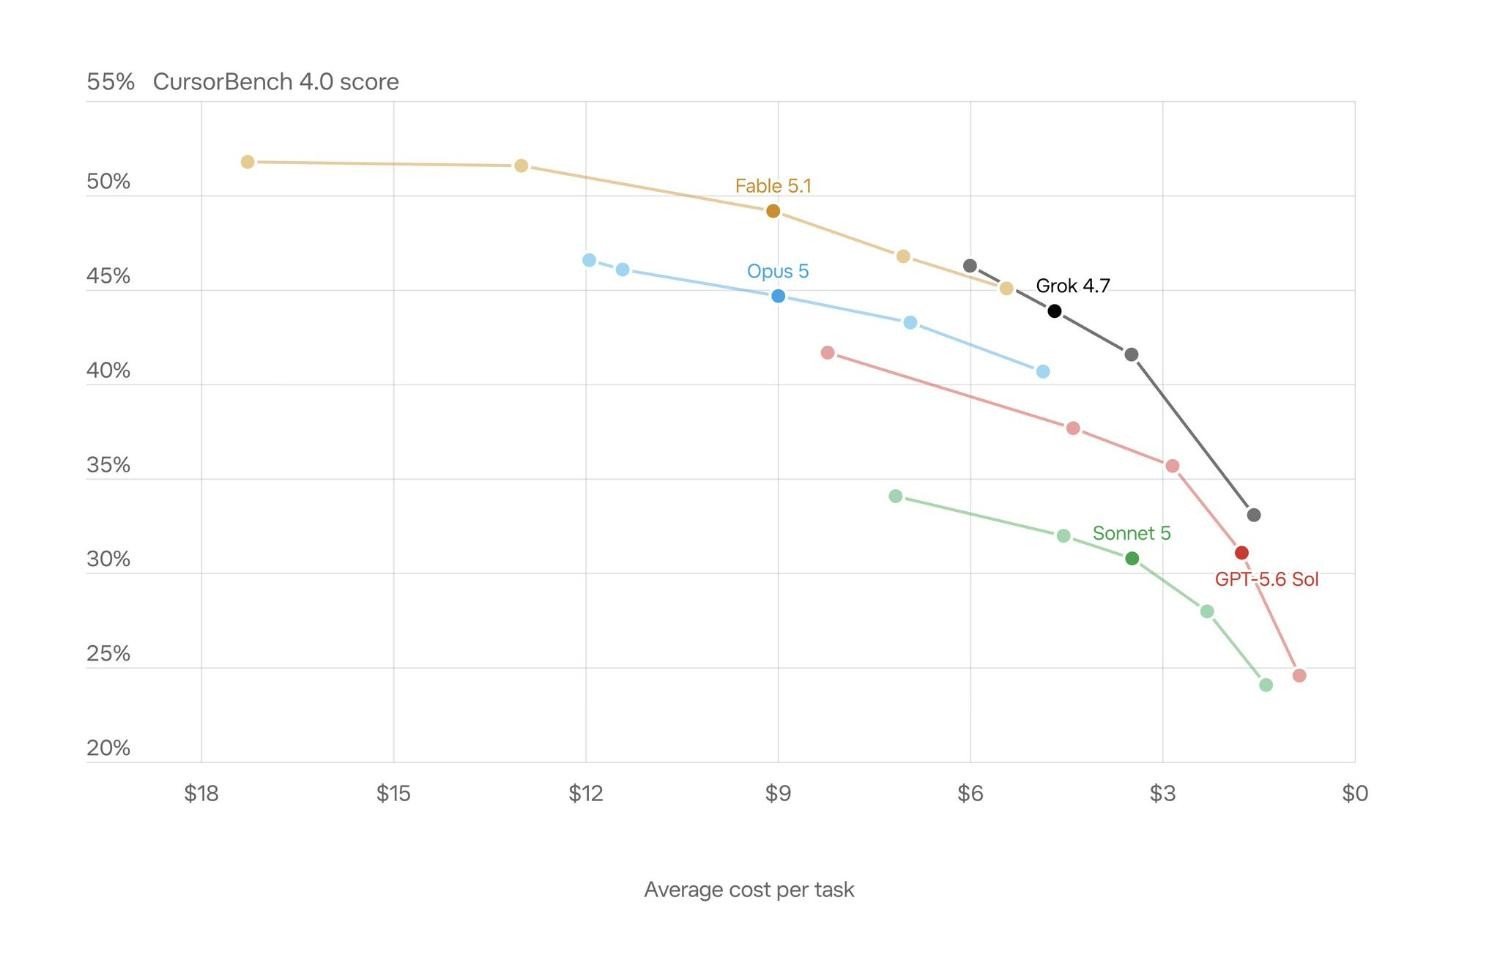
Na wykresie Grok 4.7 trzyma się granicy wyniku do ceny. Fable 5.1 jest wyżej, ale drożej. Opus 5 i GPT-5.6 Sol są niżej albo droższe.
Bezpieczeństwo. Nowy stos zabezpieczeń. 62,4% na LatchBio biosafety. Na HackerBench przez sito przeszło 3,3% ryzykownych promptów cybernetycznych. SpaceXAI nazywa to najmocniejszym modelem przy odmawianiu niebezpiecznych poleceń. Legalnej roboty z cyberbezpieczeństwa prawie nie blokuje. Wybrani partnerzy dostają dostęp do red-teamu na zaproszenie.
Cena zostaje jak przy 4.6: 2 dolary za milion tokenów wejścia, ok. 7,60 zł, i 6 dolarów za milion wyjścia, ok. 22,80 zł, po średnim kursie NBP z 18 września (3,7998 zł za dolara). Wersja Fast: dwa razy szybsze wyjście, dwa razy wyższa cena. Kontekst: 500 tys. tokenów.
Dostępny od dziś w Cursor, Grok Build i Grok API. Także w narzędziach do kodu, routerach i chmurze. SpaceXAI pisze, że Grok 4.7 jest dwa razy szybszy i o połowę tańszy od porównywalnych modeli. Z 4.6 wygrywa na każdym wymienionym teście przy tej samej cenie.
Źródło: komunikat SpaceXAI.
← Wszystkie wpisy