Grok 4.6 w ścisłej czołówce medycznych benchmarków

xAI ·

Grok 4.6 w ścisłej czołówce medycznych benchmarków

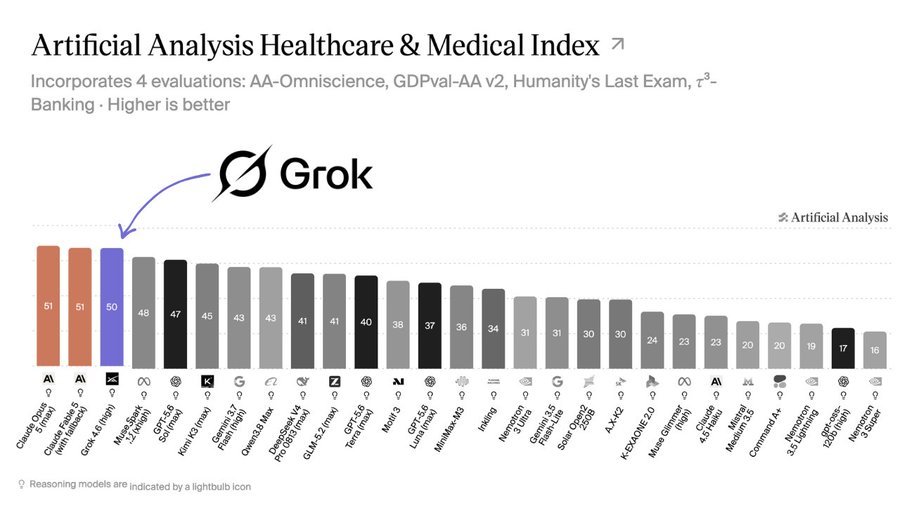
Grok 4.6 znalazł się w pierwszej trójce rankingu Artificial Analysis Healthcare & Medical Index. Wersja high: 50 punktów, zaledwie punkt za liderem (51). Wyprzedził m.in. GPT-5.6 Sol, Kimi K3 i Gemini 3.7 Flash.

Indeks ocenia wiedzę medyczną, rozumowanie kliniczne, dokumentację pacjenta, ograniczanie halucynacji i agentyczne workflow’y. Błędy w tej domenie nie są teoretyczne.

Jeszcze niedawno modele z tej rodziny były w tyle w testach medycznych. Teraz walczą o szczyt — xAI domyka dystans w zastosowaniach specjalistycznych.

Artificial Analysis Healthcare Index
Grok 4.6 high: 50 pkt, punkt za liderem.

Źródło: post @XFreeze na X. Warto oglądać kolejne aktualizacje — tempo poprawy w tej dziedzinie jest zauważalne.

← Wszystkie wpisy
Komentarze

Zamieszczając komentarz, publikujesz go pod podanym imieniem. Nie prosimy o maila.

Wczytuję…

Czytaj również

Grok Bot będzie wybierał do każdego zadania najlepszy model, także Claude Opus 5.5 od Anthropica

Elon Musk zapowiedział, że Grok Bot będzie korzystał z najlepszego modelu do zadania, także z Claude Opus 5.5, Midjourney i Suno. Bot przeszukuje już X bez konektora, a od sierpnia dostał m.in. Team Boty w Slacku, 1Password, głos, rutyny i dostęp do finansów.

Musk i Huang w Białym Domu wskazują prąd jako główne ograniczenie rozwoju SI

Musk w Białym Domu: każde 5 GW dodatkowego prądu to ok. 1 proc. PKB USA, a Starship ma wynosić na orbitę setki gigawatów mocy obliczeniowej rocznie. Huang pokazał OpenShell i BlueField do pilnowania agentów SI, Tom Brown mówił o Claude Opus 5.5, a szefowie firm podpisali deklarację o czterech poziomach kontroli.

Terafab wylewa fundamenty pół roku po ogłoszeniu, a nasze CPK potrzebowało na to dziewięciu lat

W hrabstwie Grimes w Teksasie większość stóp fundamentowych Terafabu jest już zalana betonem, pół roku po ogłoszeniu projektu. Budowa terminala CPK wciąż czeka na pozwolenie, prawie dziewięć lat po przyjęciu koncepcji.